

L’IA n’est pas nécessairement plus biaisée qu’un recruteur humain. En revanche, ses biais ne fonctionnent pas de la même manière. Un recruteur peut être influencé par une impression, une habitude ou un raccourci mental sans même s’en rendre compte. Un outil de recrutement peut reproduire ces mêmes biais à partir des données sur lesquelles il a été conçu ou entraîné.
C’est là que la comparaison devient intéressante. On oppose souvent l’IA et le jugement humain comme s’il fallait choisir entre une machine objective et un recruteur forcément subjectif. Mais aucun des deux ne part d’une position parfaitement neutre.
Les éditeurs de logiciels de recrutement promettent des outils objectifs capables de neutraliser les biais humains. Une partie des professionnels RH y voit au contraire une machine à discriminer à grande échelle. Ces deux lectures reposent pourtant sur la même erreur de départ : elles prennent le jugement humain comme référence neutre.
Or ce jugement humain est lui aussi soumis à des biais. Et ceux-ci sont documentés depuis longtemps.
Poser la question des biais de l’IA en recrutement en termes de quantité ne mène donc nulle part. Un algorithme ne se trompe pas plus souvent qu’un recruteur en fin de journée, il se trompe autrement. Là où l’erreur humaine reste isolée et rattrapable par un collègue ou par une relecture, l’erreur algorithmique s’applique à toutes les candidatures qui franchissent le filtre sans que rien ne la signale. C’est cette différence de nature qui doit guider une décision d’équipement, bien davantage que les taux affichés dans les études comparatives.
Ce que l’on sait des biais humains
La méthode de référence s’appelle le testing. Elle consiste à envoyer à un même recruteur 2 candidatures identiques, à l’exception du critère dont on cherche à mesurer l’effet. On compare ensuite le nombre de candidats convoqués en entretien.
Un testing de la DARES mené auprès d’environ 40 grandes entreprises françaises montre qu’une candidature portant un nom à consonance maghrébine est rappelée 31,5 % moins souvent qu’une candidature équivalente portant un nom à consonance française. Les candidatures obtiennent respectivement 22,8 % et 33,3 % de réponses positives (DARES).
Le phénomène ne concerne pas uniquement les entreprises privées. Le programme de testing conduit pour la DGAFP sur 2 594 offres d’emploi entre 2015 et 2022 montre que, sur les offres publiques de cadre administratif de la dernière vague, un candidat portant un nom à consonance maghrébine obtenait 27 % de réponses positives contre 39 % pour le candidat de référence (Challe, L’Horty et Petit, rapport annuel sur l’état de la fonction publique, édition 2022).
Ces écarts ne traduisent aucune intention de discriminer. Ils résultent de raccourcis mentaux qui s’activent en quelques secondes de lecture de CV sans que la personne s’en aperçoive, et que 5 mécanismes documentés suffisent à expliquer pour l’essentiel.
La comparaison entre l’humain et la machine démarre donc sur un constat rarement énoncé, celui que le jugement d’un recruteur n’est pas neutre. Il peut être biaisé, y compris lorsque la personne qui recrute pense prendre une décision objective.
Ce que montrent les tests menés sur les outils
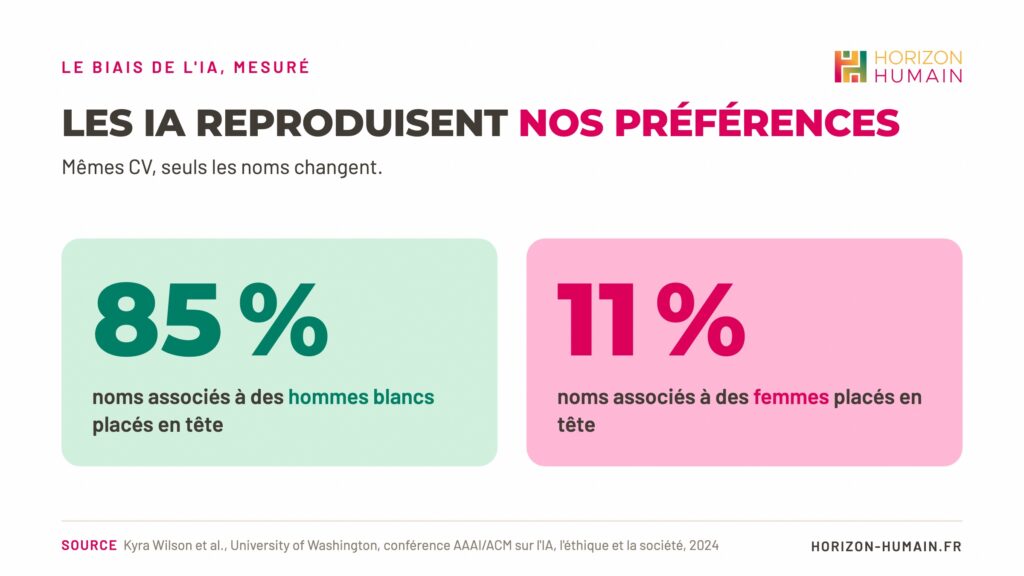
Des chercheuses et chercheurs de l’University of Washington ont testé 3 grands modèles de langage capables de classer des candidatures à partir de 550 CV réels. Pour mesurer l’effet du nom sur le classement, ils ont conservé les CV identiques et fait varier uniquement les prénoms et les noms associés à différentes origines et différents genres. Au total, le test a porté sur plus de 3 millions de combinaisons entre un poste, un nom et un profil supposé.
Les modèles ont retenu en priorité les noms associés à des hommes blancs dans 85 % des cas, contre 11 % pour les noms associés à des femmes. Les candidatures portant un nom associé à un homme noir arrivent en dernière position et se voient préférer un autre profil dans la quasi-totalité des comparaisons (Kyra Wilson et al., University of Washington, présenté à la conférence AAAI/ACM sur l’IA, l’éthique et la société, 2024).
Ce n’est pas la première fois qu’un outil de recrutement reproduit les biais présents dans les données qui ont servi à l’entraîner. Amazon en a fait l’expérience avec un outil interne développé à partir de 10 années de CV, issus en grande majorité d’hommes pour les métiers techniques. À force d’observer ces candidatures, le modèle a fini par associer le fait d’être un homme à un meilleur profil technique. Il pénalisait ainsi certains CV contenant le terme women’s, notamment dans « women’s chess club captain », et défavorisait les diplômées d’universités non mixtes. Aucun correctif n’a permis de récupérer l’outil, si bien que le projet a été abandonné avant sa mise en service, comme l’a révélé Reuters en 2018.
Dans les deux cas, le mécanisme reste identique. La machine n’invente aucun préjugé et se contente d’apprendre ceux qui figurent dans les données qu’on lui fournit, c’est-à-dire les nôtres, puis elle les applique sans jamais s’interroger.
3 différences entre une erreur humaine et une erreur algorithmique
Comparer les pourcentages relevés d’un côté et de l’autre n’apprend pas grand-chose, car la vraie question porte sur la nature de l’erreur commise plutôt que sur sa fréquence.
1. L’échelle de l’erreur
Un recruteur biaisé fausse ses propres recrutements et rien d’autre. Un algorithme biaisé fausse en revanche toutes les candidatures qui passent par lui, chaque jour et sur chaque poste, dans l’ensemble des services qui l’utilisent. Le même défaut ne produit donc pas les mêmes conséquences selon qu’il vient d’une personne ou d’un logiciel utilisé par toute l’entreprise.
C’est ce qui explique l’affaire Mobley v. Workday aux États-Unis. Un candidat qui avait postulé plus de 100 fois par l’intermédiaire de la même plateforme et essuyé autant de refus a fini par attaquer l’éditeur du logiciel. En mai 2025, une juge fédérale a autorisé la procédure à se poursuivre comme action collective nationale au titre de la discrimination par l’âge, en considérant que l’éditeur pouvait être tenu de répondre en tant qu’agent des employeurs. Une simple erreur de paramétrage chez un fournisseur se transforme ainsi en contentieux de masse.
2. Un biais difficile à repérer
Un biais humain laisse souvent des indices. Une remarque pendant un débrief, une hésitation devant un CV, un désaccord entre deux évaluateurs ou une décision difficile à justifier permettent parfois de comprendre ce qui s’est passé. Un biais algorithmique, lui, apparaît sous forme de score, et un score donne facilement l’impression d’être objectif, même lorsqu’il repose sur des critères discutables.
Une équipe de l’université RWTH d’Aix-la-Chapelle a placé 260 participants en situation de présélection assistée par un système de recommandation volontairement biaisé. Interrogés explicitement sur la présence d’un biais, environ 60 % ne l’ont pas remarqué (Rosenthal-von der Pütten et Sach, Frontiers in Psychology, 2024). L’étude montre aussi un résultat plus encourageant, à savoir que les participants qui s’appuyaient moins sur l’algorithme repéraient mieux le biais.
3. Toujours la même erreur, sans variation
C’est la différence la moins visible, et sans doute la plus importante.
Le jugement humain reste irrégulier par nature. Un même recruteur n’évalue pas de la même manière à 9 heures et à 18 heures, avant et après un entretien qui s’est mal passé, en début et en fin de semaine. Cette irrégularité constitue un défaut de fiabilité qui coûte cher à l’entreprise, mais elle laisse aussi passer du monde. Un profil écarté par un recruteur fatigué peut très bien être retenu par ce même recruteur reposé, ou par la personne qui occupe le bureau d’à côté.
Un algorithme ne fonctionne pas de cette façon. S’il applique un même critère à chaque candidature, il le reproduit aussi longtemps que ce critère reste en place. Cette constance est une qualité quand le critère est pertinent. Quand il ne l’est pas, elle revient à répéter la même erreur sur chaque candidature.
« De toute façon, un humain valide à la fin »
La réponse spontanée à tout ce qui précède consiste à dire qu’un humain valide toujours à la fin. Cette réponse est fragile pour 2 raisons.
La première est comportementale. Les 60 % de participants qui n’ont pas repéré le biais dans l’étude d’Aix-la-Chapelle donnent une bonne idée du risque. Lorsqu’une personne reçoit une liste déjà triée par un outil, elle ne reprend pas nécessairement chaque candidature depuis le début. Plus le volume est important, plus il devient tentant de faire confiance au classement proposé. Le contrôle humain peut alors se réduire à vérifier les premiers profils ou à confirmer une décision déjà largement préparée par la machine.
La seconde est juridique. Lorsqu’un outil fait passer 1 000 candidatures à 10 profils à examiner, il a déjà pesé très fortement sur la décision, même si un recruteur intervient ensuite. C’est la lecture retenue par le règlement général sur la protection des données, et la CNIL a d’ailleurs inscrit le recrutement parmi ses thématiques prioritaires de contrôle pour 2026 en visant explicitement les systèmes de prise de décision automatisée, l’information des candidats et les durées de conservation (communiqué du 3 avril 2026). Ces contrôles viseront en priorité les grandes entreprises et les cabinets de recrutement, compte tenu du volume de candidatures qu’ils traitent, mais les obligations qu’ils vérifient s’appliquent à tout employeur.
Tout se joue sur ce que l’outil cherche à optimiser
Des chercheurs du MIT ont testé plusieurs algorithmes de présélection sur des données réelles de recrutement dans une entreprise du Fortune 500, et leurs résultats déplacent complètement le débat entre l’IA et l’humain. Avec un apprentissage supervisé classique, celui que proposent la plupart des outils commerciaux et qui consiste à repérer les profils ressemblant aux personnes déjà recrutées, le taux d’embauche progresse mais la part combinée de candidats noirs ou hispaniques convoqués tombe à 2 % ou 5 % selon la variante testée.
Un autre algorithme, conçu pour explorer davantage les profils sur lesquels l’entreprise avait peu d’historique, faisait passer cette part de 10 % à 24 %, avec un taux d’embauche parmi les personnes convoquées qui progressait de 10 % à 25 % (Li, Raymond et Bergman, Hiring as Exploration, MIT / NBER).
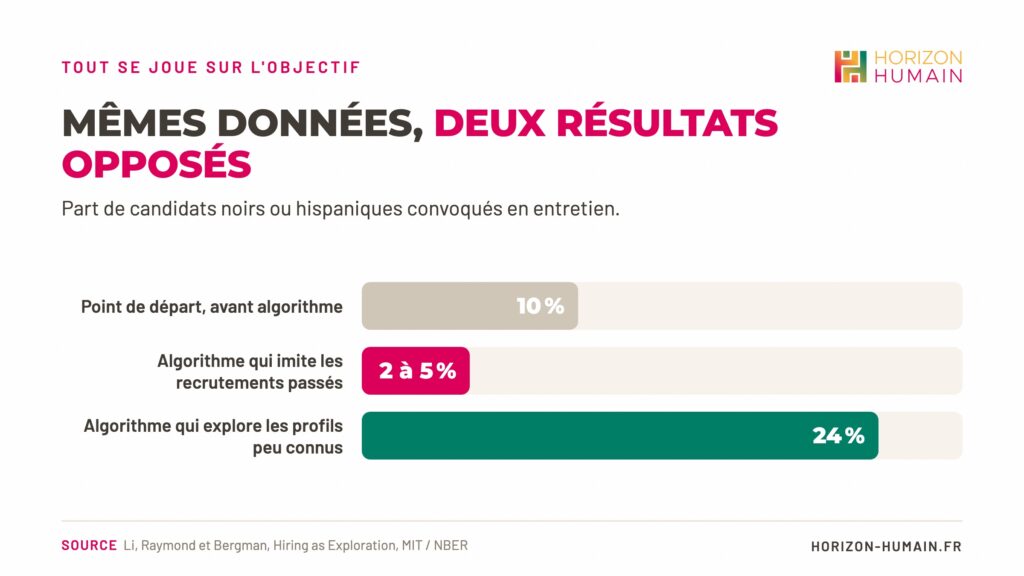
Même entreprise, mêmes données, seul l’objectif d’optimisation change et il suffit à produire deux résultats opposés aussi bien sur la diversité que sur la qualité des embauches. La question à poser porte donc moins sur la technologie retenue que sur ce que l’outil cherche à maximiser. Un logiciel qui vise à reproduire vos recrutements passés reproduira aussi vos erreurs passées, en allant simplement plus vite et avec beaucoup plus de régularité.
Ce que ça change pour une PME qui recrute
Un dirigeant de TPE/PME ne va pas auditer un modèle d’IA, et ce n’est d’ailleurs pas ce qu’on lui demande. En revanche, il peut s’assurer que la manière dont son entreprise trie et évalue les candidats repose sur des critères suffisamment clairs pour ne pas laisser l’outil décider à sa place.
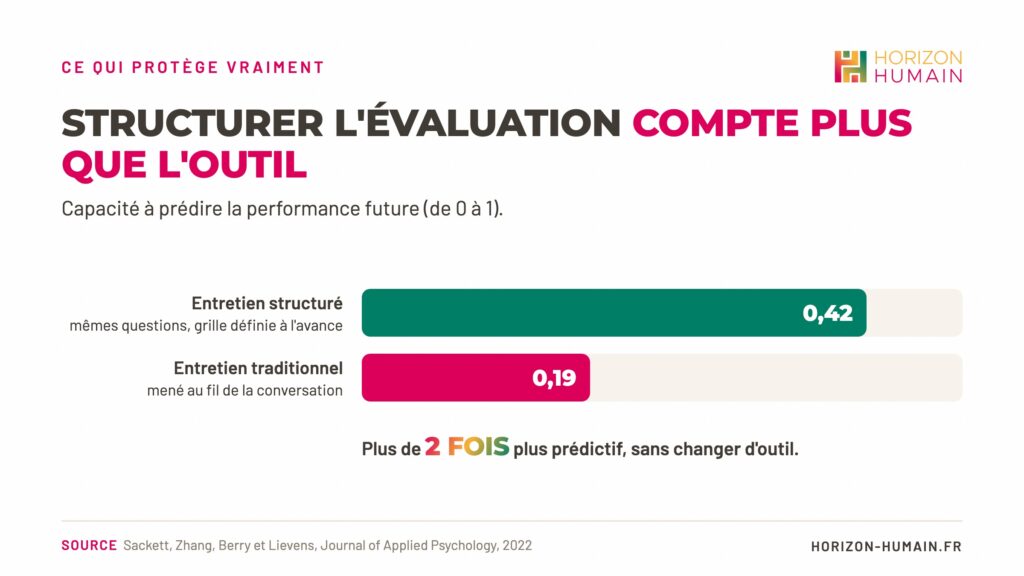
Les recherches sur la sélection confirment ce point. Un entretien structuré, avec les mêmes questions et une grille définie à l’avance, prédit mieux la performance future qu’un entretien traditionnel mené au fil de la conversation. La validité prédictive est d’environ 0,42 pour le premier, contre 0,19 pour le second (Sackett, Zhang, Berry et Lievens, Journal of Applied Psychology, 2022). Autrement dit, structurer l’évaluation compte davantage que simplement changer d’outil si les décisions continuent d’être prises au feeling.
La protection contre les biais commence avant le sourcing. Ce qui fait la différence, ce sont les critères appliqués, bien plus que la personne ou l’outil qui les applique. Sans critères définis à l’avance, le premier CV lu devient la référence, l’entretien sert à confirmer une impression et l’outil finit par reproduire cette logique.
Il reste un réflexe simple que nous conseillons de faire régulièrement. Regardez ce que votre filtre a écarté. Prenez chaque mois un échantillon des candidatures rejetées automatiquement et demandez-vous si certaines auraient mérité d’être examinées, parce que l’outil ne vous montrera jamais les profils qu’il a fait disparaître.
Les 3 questions à poser à votre éditeur
Ces 3 questions se posent par écrit avant toute signature, et les réponses obtenues vous renseigneront autant sur l’outil que sur le sérieux du fournisseur.
- Sur quelles données votre modèle a-t-il été entraîné, et le tri s’appuie-t-il sur nos recrutements passés ? Si c’est le cas, il risque de reproduire vos habitudes de recrutement, y compris celles que vous cherchez justement à corriger.
- Quels critères déclenchent une élimination automatique, et pouvons-nous les désactiver ? Demandez lesquels sont utilisés et s’ils peuvent être désactivés. Les filtres liés aux interruptions de parcours ou aux correspondances exactes de mots-clés méritent notamment d’être vérifiés.
- Quelle documentation fournissez-vous pour un contrôle CNIL ou pour l’information des candidats ? La documentation disponible doit permettre de comprendre le fonctionnement du système et de répondre aux demandes de contrôle. Si l’éditeur n’a pas de réponse claire, vous risquez de devoir gérer seul les conséquences de l’utilisation de l’outil.
Pourquoi l’IA ne remplacera pas le chargé de recrutement
On lit depuis 2 ans que le métier serait menacé, alors que la nature même du tri automatique conduit à la conclusion inverse.
Un outil peut comparer une candidature à une liste de critères définis à l’avance. Le recruteur, lui, doit pouvoir regarder au-delà de cette liste, repérer une compétence qui n’apparaît pas sous le bon intitulé, comprendre une reconversion, tenir compte d’une progression ou défendre un profil qui ne correspond pas parfaitement à la fiche de poste, mais qui pourrait pourtant réussir dans l’entreprise après quelques mois de montée en compétences.
C’est précisément là que se trouve la valeur du métier. L’IA peut prendre en charge une partie du tri et faire gagner un temps considérable sur les tâches répétitives, mais elle ne peut pas remplacer le jugement nécessaire pour comprendre un parcours, mettre une candidature en perspective et prendre une décision qui engage l’entreprise.
Un outil ne fabrique donc pas un bon processus de recrutement, il amplifie celui qui existe déjà. Lorsque les critères sont clairs et définis avant de rencontrer les candidats, l’IA peut rendre le processus plus rapide et plus efficace. Lorsque ces critères reposent sur des habitudes ou des recrutements passés que personne n’a pris le temps d’interroger, elle risque au contraire de reproduire ces mêmes choix à plus grande échelle.
L’enjeu n’est pas de savoir si l’IA doit entrer dans le recrutement, mais de savoir quelle place on lui donne. Elle peut trier, comparer et faire gagner du temps, à condition que le jugement final reste une responsabilité humaine.
FAQ
Non, elle est simplement biaisée autrement. Dans une étude menée par l’University of Washington sur 550 CV réels, 3 modèles de langage ont préféré les noms associés à des hommes blancs dans 85 % des cas, contre 11 % pour les noms associés à des femmes. L’IA n’invente pas ces préférences puisqu’elle les apprend dans les données historiques qu’on lui fournit, mais elle les applique ensuite de la même façon sur tous les dossiers.
Oui, et cette discrimination engage la responsabilité de l’employeur autant que celle de l’éditeur du logiciel. Aux États-Unis, l’affaire Mobley v. Workday a été autorisée à se poursuivre comme action collective nationale en mai 2025 au titre de la discrimination par l’âge. En France, l’article L1221-6 du code du travail impose que les informations demandées à un candidat présentent un lien direct et nécessaire avec l’emploi proposé, et cette exigence s’applique quel que soit l’outil utilisé pour les collecter ou les traiter.
Non, pour 2 raisons distinctes. Environ 60 % des personnes placées face à un système de recommandation biaisé ne repèrent pas le biais alors même qu’on les interroge explicitement sur son existence (Frontiers in Psychology, 2024). Sur le plan juridique, un outil qui ramène 1 000 candidatures à une liste de 10 détermine la décision finale, y compris lorsqu’un humain la valide formellement ensuite.
Demandez à l’éditeur sur quelles données le modèle a été entraîné, quels critères déclenchent une élimination automatique et quelle documentation il met à votre disposition en cas de contrôle. En interne, relisez chaque mois un échantillon des candidatures rejetées automatiquement et comparez le profil des candidats convoqués avant et après la mise en service de l’outil, c’est le moyen le plus simple de repérer un critère qui écarte une population entière.
Sources
- DARES, testing sur les discriminations à l’embauche selon l’origine
- Challe, L’Horty et Petit, testing Desperado, DGAFP / TEPP-CNRS, rapport annuel sur l’état de la fonction publique, édition 2022
- Wilson et al., University of Washington (2024)
- Rosenthal-von der Pütten et Sach, Frontiers in Psychology (2024)
- Li, Raymond et Bergman, Hiring as Exploration (MIT/NBER)
- Sackett, Zhang, Berry et Lievens, Journal of Applied Psychology (2022)
- CNIL, thématiques prioritaires de contrôle 2026 (3 avril 2026)
- Article L1221-6 du code du travail